
เคยไหมคะ? ประชุมจบแล้วรู้ว่าต้องมานั่งไล่ฟังเสียงอีกรอบเพื่อจดประเด็นและงานที่ต้องทำ? ยิ่งเป็นประชุมที่มีชื่อลูกค้า ตัวเลข หรือข้อมูลภายใน ก็ยิ่งลังเลว่าจะอัปโหลดไฟล์เสียงขึ้นบริการ Cloud ดีไหม
บทความนี้แอดเลยลองทำ Meeting Summarizer ภาษาไทยแบบ Local ตั้งแต่ถอดเสียงจนได้สรุปการประชุม โดยให้ไฟล์เสียงและ Transcript อยู่บน Mac ของเราเป็นหลัก มาดูไปพร้อมกันว่า Local LLM คืออะไร ติดตั้งอย่างไร และผลจริงออกมาใช้ได้แค่ไหนค่ะ
Local LLM คืออะไร?
Local LLM คือโมเดลภาษาที่รันบนคอมพิวเตอร์ของเราเอง แทนการส่งข้อความไปให้เซิร์ฟเวอร์บน Cloud ประมวลผล ในโปรเจกต์นี้ Local LLM รับ Transcript ที่ถอดเสียงแล้ว แล้วช่วยดึงประเด็นสำคัญ ข้อสรุป และ Action Items ออกมาเป็น Meeting Summary
ข้อดีที่เห็นได้ชัดคือ เราควบคุมไฟล์และขั้นตอนการทำงานเองได้ เหมาะกับการทดลองกับข้อมูลภายใน งานที่ต้องการทำแบบออฟไลน์หลังเตรียมโมเดลไว้แล้ว หรือทีมที่อยากต่อยอด workflow เฉพาะตัว เช่น ให้สรุปออกตามรูปแบบรายงานของบริษัท
การใช้โมเดล Local เครื่องต้องมี RAM เพียงพอสำหรับโมเดลที่จะนำมาใช้ด้วย รุ่นเล็กอาจพลาดชื่อเฉพาะ ตัวเลข และบริบทที่พูดเร็ว ๆ ได้ ดังนั้นยังต้องมีคนตรวจผลก่อนส่งรายงานจริงเสมอ แอดมองว่า Local LLM เหมาะเป็นผู้ช่วยร่างสรุป ไม่ใช่ผู้อนุมัติข้อมูลแทนคน
ทำความรู้จัก Ollama ก่อนเริ่ม
Ollama คือเครื่องมือที่ช่วยดาวน์โหลดและรันโมเดลภาษาไว้บนเครื่อง โดยมีทั้งคำสั่ง CLI และ Local API ให้โปรแกรมของเราเรียกใช้ได้ ในรอบนี้แอดเลือก Ollama เพราะติดตั้งง่าย ใช้คำสั่งสั้น ๆ เพื่อดึงโมเดล และต่อเข้ากับเว็บผ่าน http://127.0.0.1:11434 ได้ทันที
ก่อนเลือก Ollama ลองเทียบตัวเลือกที่พบบ่อยแบบเร็ว ๆ ค่ะ
| เครื่องมือ | เหมาะกับใคร | จุดเด่น | ข้อควรรู้ |
| Ollama | อยากเริ่มด้วยคำสั่งและต่อ API | ติดตั้งง่าย, pull/run โมเดลได้, Local API พร้อม | ต้องดู RAMและพื้นที่โมเดลเอง |
| LM Studio | อยากเลือกโมเดลผ่านหน้าจอ | มี UI ช่วยค้นหา/ทดลองโมเดล | ถ้าจะต่อระบบต้องเปิด Local Server และตั้งค่าต่อ |
| llama.cpp | อยากจูนละเอียดหรือฝังในแอป | เบาและยืดหยุ่น, รองรับ GGUF | เริ่มต้นยากกว่าและต้องจัดการคำสั่งเอง |
โจทย์ที่แอดลองทำ
เป้าหมายคือการช่วยลดเวลาจาก ไฟล์เสียงภาษาไทย เป็น การสรุปที่มีประเด็น ข้อสรุป และงานที่ต้องตามต่อ โดยยังรักษาข้อมูลเดิมไว้บนเครื่อง
สภาพแวดล้อมที่ใช้ทดสอบ
- RAM 16 GB
- MLX Whisper: mlx-community/whisper-large-v3-mlx สำหรับถอดเสียง
- Ollama และโมเดล qwen3:4b สำหรับสรุป
- เว็บ Local สำหรับเลือกไฟล์ ดู Transcript และกดสรุป
Step 1: ติดตั้ง Ollama
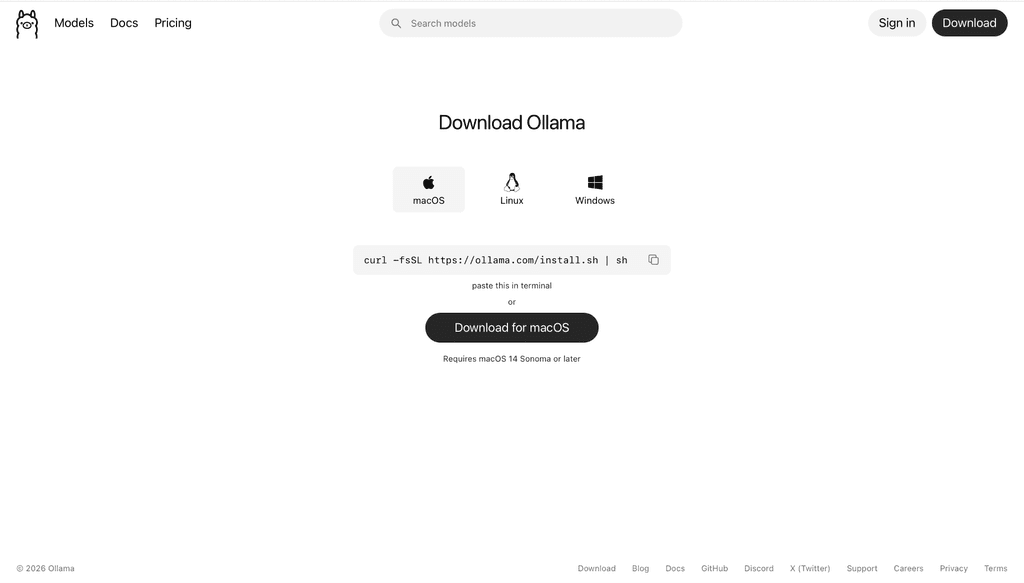
เข้าไปดาวน์โหลด Ollama ที่ https://ollama.com/download แล้วติดตั้งเหมือนแอปทั่วไป เมื่อเปิด Ollama แล้ว ให้ลองเปิด Terminal และพิมพ์คำสั่งด้านล่างเพื่อตรวจว่าพร้อมใช้งาน
ollama --version
Step 2: ดาวน์โหลดโมเดล Qwen3:4b
ดึงโมเดลที่ใช้สรุปลงเครื่องด้วยคำสั่งนี้
ollama pull qwen3:4b
หรือถ้าอยากดาวน์โหลดและลองคุยกับโมเดลทันทีโดยใช้
ollama run qwen3:4b
ครั้งแรกจะใช้เวลาตามความเร็วอินเทอร์เน็ต เพราะต้องดาวน์โหลดโมเดลก่อน หลังจากนั้นจึงรันแบบ Local ได้ค่ะ รอบนี้แอดเลือก Qwen3:4b เพราะขนาดกำลังพอดีกับเครื่องทดสอบและเริ่มทดลองภาษาไทยได้โดยไม่หนักเกินไป
Step 3: ภาพรวมโปรเจกต์ที่เราจะทำ
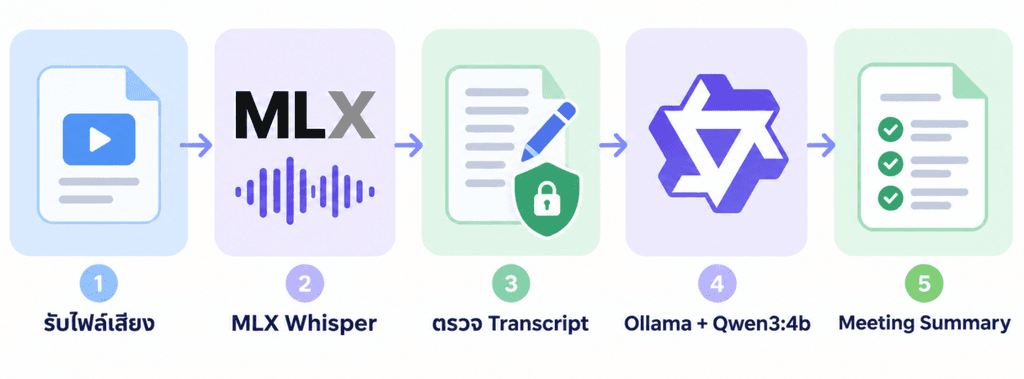
ภาพรวม pipeline ของโปรเจกต์นี้ คือ รับไฟล์เสียง → ถอดเสียง → ตรวจ Transcript → สรุป
โค้ดและตัวอย่างโปรเจกต์: https://github.com/Kaewkloaw/Meeting-Summarizer-Local
Step 4: ส่วนไหนของโค้ดที่คุยกับ Local Model?
หัวใจของการเชื่อมต่ออยู่ที่การส่ง prompt และ Transcript ไปยัง Local API ของ Ollama ผ่าน 127.0.0.1:11434 ซึ่งหมายถึงเรียกบริการที่กำลังรันอยู่บนเครื่องเดียวกัน ไม่ได้ส่งข้อความไปยัง API ภายนอก
ตัวอย่างโค้ดที่สำคัญจะมีหน้าตาประมาณนี้
payload = {
    "model": "qwen3:4b",
    "prompt": prompt,
    "stream": False,
    "think": False,
    "options": {"temperature": 0}
}

request = urllib.request.Request(
    "http://127.0.0.1:11434/api/generate",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"}
)

with urllib.request.urlopen(request) as response:
    result = json.load(response)

f.write(result["response"].strip() + "\n")
prompt คือคำสั่งพร้อม Transcript ที่เราจะให้โมเดลอ่าน, model ระบุว่าจะใช้ qwen3:4b, temperature: 0 ลดความสุ่มของคำตอบ, และ result[“response”] คือข้อความสรุปที่โมเดลส่งกลับมา จากนั้นโปรเจกต์นำผลลัพธ์ไปแสดงบนหน้าเว็บและบันทึกเป็นไฟล์สรุป
เริ่มจาก Transcript ก่อน
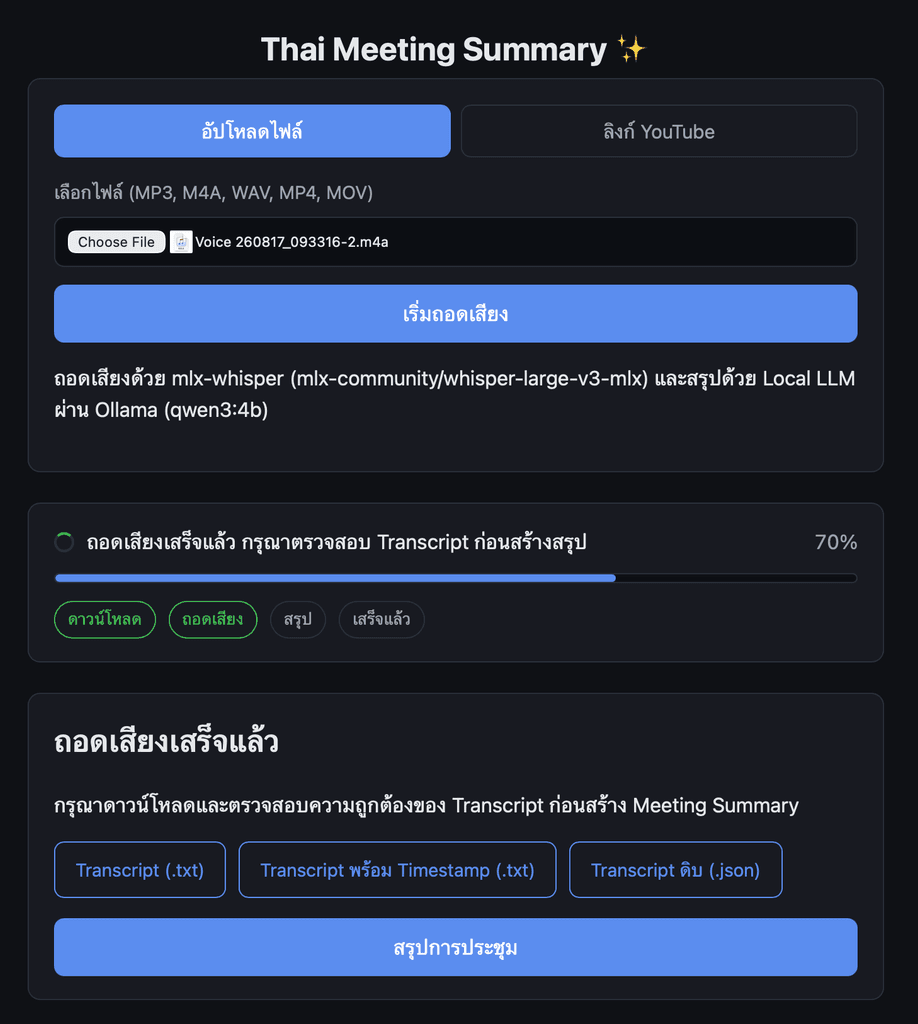
นี่คือตัวอย่างข้อความที่ได้ทันทีหลัง MLX Whisper ถอดเสียง (บางทีอาจจะไม่ผลลัพธ์ที่ไม่ค่อยดี เนื่องจากเราใช้ตัวที่เล็ก ประสิทธิภาพอาจจะไม่ถึงขั้นแม่นยำ อยู่ในเกณฑ์ที่พอใช้ได้ค่ะ)
[00:02:10] วันนี้คุยเรื่องโปรเจกต์ next ocr นะคะ
[00:02:18] คุณฝนขอให้เพิ่มหน้าตรวจเชคยอดก่อนเซฟ
[00:02:29] ทีมบอกว่าจะส่งไฟล์ตัวอย่างภายในวันพฤหัสที่สิบแปด
[00:02:40] รอบแรกลองกับข้อมูลเดโม่ก่อน ยังไม่ใช้ของจริง
บางที Transcript อาจจะไม่ผลลัพธ์ที่ไม่ค่อยดี เนื่องจากเราใช้ตัวที่เล็ก ประสิทธิภาพอาจจะไม่ถึงขั้นแม่นยำ อยู่ในเกณฑ์ที่พอใช้ได้ค่ะแต่ยังมีจุดที่ต้องระวัง เช่น ชื่อคนอาจผิด, คำเฉพาะอาจสะกดไม่ตรง และวัน/ตัวเลขเป็นข้อมูลที่ไม่ควรเดา แอดจึงตรวจเฉพาะจุดสำคัญก่อนสรุป แทนการแก้ทุกคำจนเสียเวลา
ตัวอย่างหลังแก้คำสำคัญ
[00:02:10] วันนี้คุยเรื่องโปรเจกต์ NextOCR นะคะ
[00:02:18] คุณฝนขอให้เพิ่มหน้าตรวจสอบยอดก่อนบันทึก
[00:02:29] ทีมจะส่งไฟล์ตัวอย่างภายในวันพฤหัสบดีที่ 18
[00:02:40] รอบแรกทดสอบกับข้อมูลตัวอย่างก่อน ยังไม่ใช้ข้อมูลลูกค้าจริง
แล้ว Mask ข้อมูลตอนไหน?
ถ้า MLX Whisper และ Ollama ทำงานบนเครื่องเดียวกัน เราไม่จำเป็นต้อง Mask ก่อนส่ง Transcript ให้ Local LLM เพราะไฟล์ยังอยู่ในเครื่อง แต่หากจะนำตัวอย่างไปเผยแพร่ ส่งให้คนภายนอก หรือใส่ในบทความ ควรปกปิดข้อมูลที่ระบุตัวบุคคล/องค์กรได้ก่อน เช่น ชื่อคน ชื่อลูกค้า อีเมล เบอร์โทร เลขบัญชี และชื่อโครงการที่ยังไม่เปิดเผย
แอดใช้วิธีตรวจคำสำคัญก่อน แล้วแทนค่าด้วย token ที่อ่านรู้เรื่อง เช่น [PERSON_1], [CLIENT_1], [PROJECT_1] วิธีนี้ทำให้ยังเห็นบริบทพอจะอธิบาย workflow ได้ โดยไม่เปิดเผยข้อมูลจริง
ก่อน Mask
[00:02:18] คุณฝนจากบริษัท ABC ขอให้เพิ่มหน้าตรวจสอบยอดก่อนบันทึก
หลัง Mask
[00:02:18] [PERSON_1] จาก [CLIENT_1] ขอให้เพิ่มหน้าตรวจสอบยอดก่อนบันทึก
Step 5: ให้ Qwen3:4b สรุป Transcript
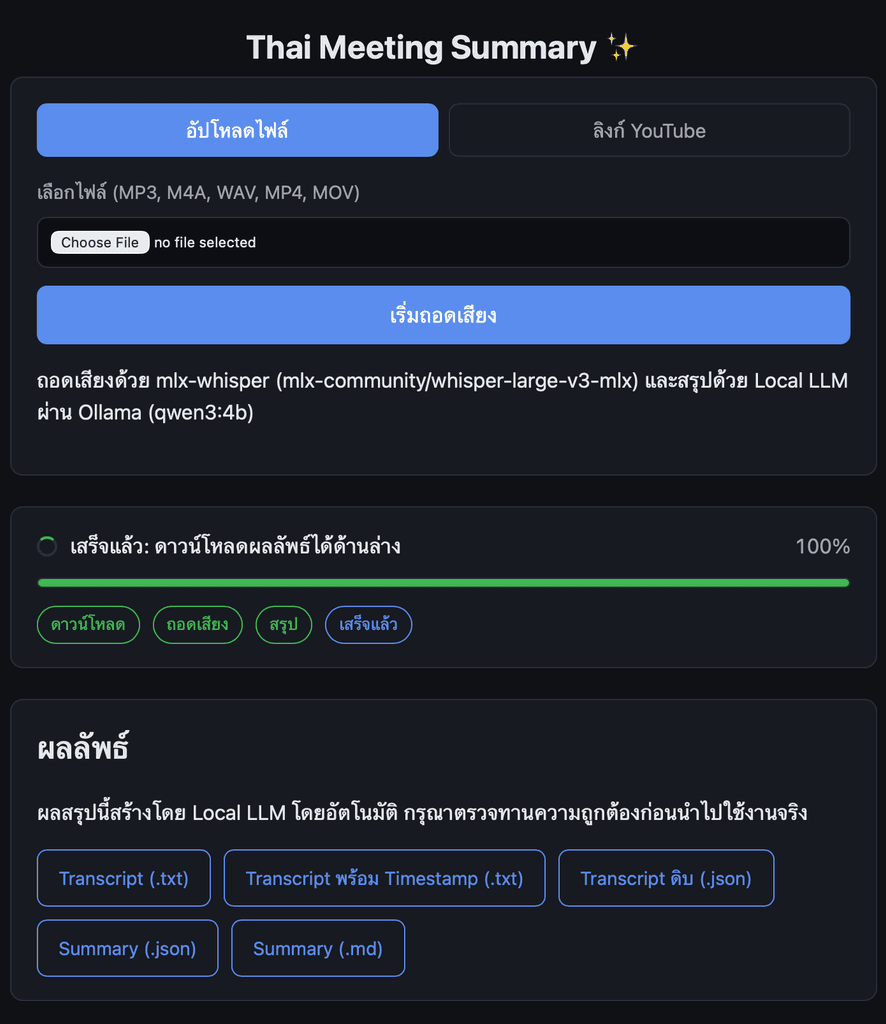
หลังตรวจคำสำคัญแล้ว กด “สรุปการประชุม” ระบบจะส่ง Transcript เข้า Ollama พร้อม prompt ที่กำชับว่าใช้ข้อมูลจากต้นฉบับเท่านั้น และหากไม่มีผู้รับผิดชอบหรือกำหนดส่ง ต้องเขียนว่า “ไม่ระบุ” แทนการเดา
ผลลัพธ์ที่ต้องการจะมี 4 ส่วน: ประเด็นสำคัญ, Decisions, Action Items และสิ่งที่ยังไม่ชัดเจน จุดนี้ช่วยให้เราอ่านร่างสรุปเร็วขึ้น แล้วค่อยเทียบกับ Transcript อีกครั้งโดยเฉพาะชื่อ ตัวเลข วันที่ และความรับผิดชอบ
ข้อสรุป
จากการทดลอง ระบบช่วยจับหัวข้อและ Action Items ได้ครบในระดับที่ใช้เป็นร่างแรกได้ดี แต่ตัวเลขมีความเพี้ยนอยู่บ้าง จึงยังไม่ควรคัดลอกไปใช้เป็นรายงานฉบับจริงทันที
สิ่งที่แอดได้จากโปรเจกต์นี้คือ Local LLM ทำให้เราคุมข้อมูลและ workflow ได้มากขึ้นมาก โดยเฉพาะงานที่อยากเก็บไฟล์เสียงไว้ในเครื่อง แต่คุณภาพสรุปจะดีแค่ไหนก็ยังขึ้นกับคุณภาพเสียง การตรวจ Transcript และความสามารถของโมเดล
ถ้าจะนำไปใช้ต่อ แอดแนะนำให้เริ่มจากการกำหนด format ของ Summary ให้ชัด, บังคับให้โมเดลอ้างอิงเฉพาะ Transcript, และเพิ่มขั้นตอนตรวจชื่อ/ตัวเลข/วันที่อัตโนมัติก่อนส่งออก เท่านี้ก็จะได้ผู้ช่วยสรุปประชุมที่ลดงานซ้ำ ๆ ได้จริง โดยไม่ต้องย้ายข้อมูลดิบออกจากเครื่องค่ะ